개요
같은 질문을 Claude에 보내도 모델이나 언어가 바뀌면 답변의 태도가 달라질 수 있다.
Anthropic은 이 차이를 막연한 "말투"가 아니라 응답에 나타난 가치 표현으로 측정했다.
2026년 7월 공개한 연구는 Sonnet 4.6, Opus 4.6, Opus 4.7과 Claude.ai에서 많이 쓰이는 20개 언어를 비교한다.
여기서 가치란 Claude가 실제로 신념을 가진다는 뜻이 아니다. 정직, 신중함, 배려처럼 출력에 드러난 규범적 판단을 말한다. 고객 지원이나 코드 리뷰처럼 답변 태도가 결과에 영향을 주는 서비스라면 모델 선택과 다국어 QA에 참고할 수 있다.
주요 특징
이전 연구인 Values in the Wild는 익명화된 대화 70만 건에서 3,307개의 가치를 찾았다.
이번에는 비슷한 의미를 수작업으로 묶어 339개로 줄였다. 그 뒤 2026년 5월 2주 동안 수집한 주관적 과제 대화 309,815건을 분석했다. 3개 모델과 20개 언어 조합별 표본은 약 5,000건이다.
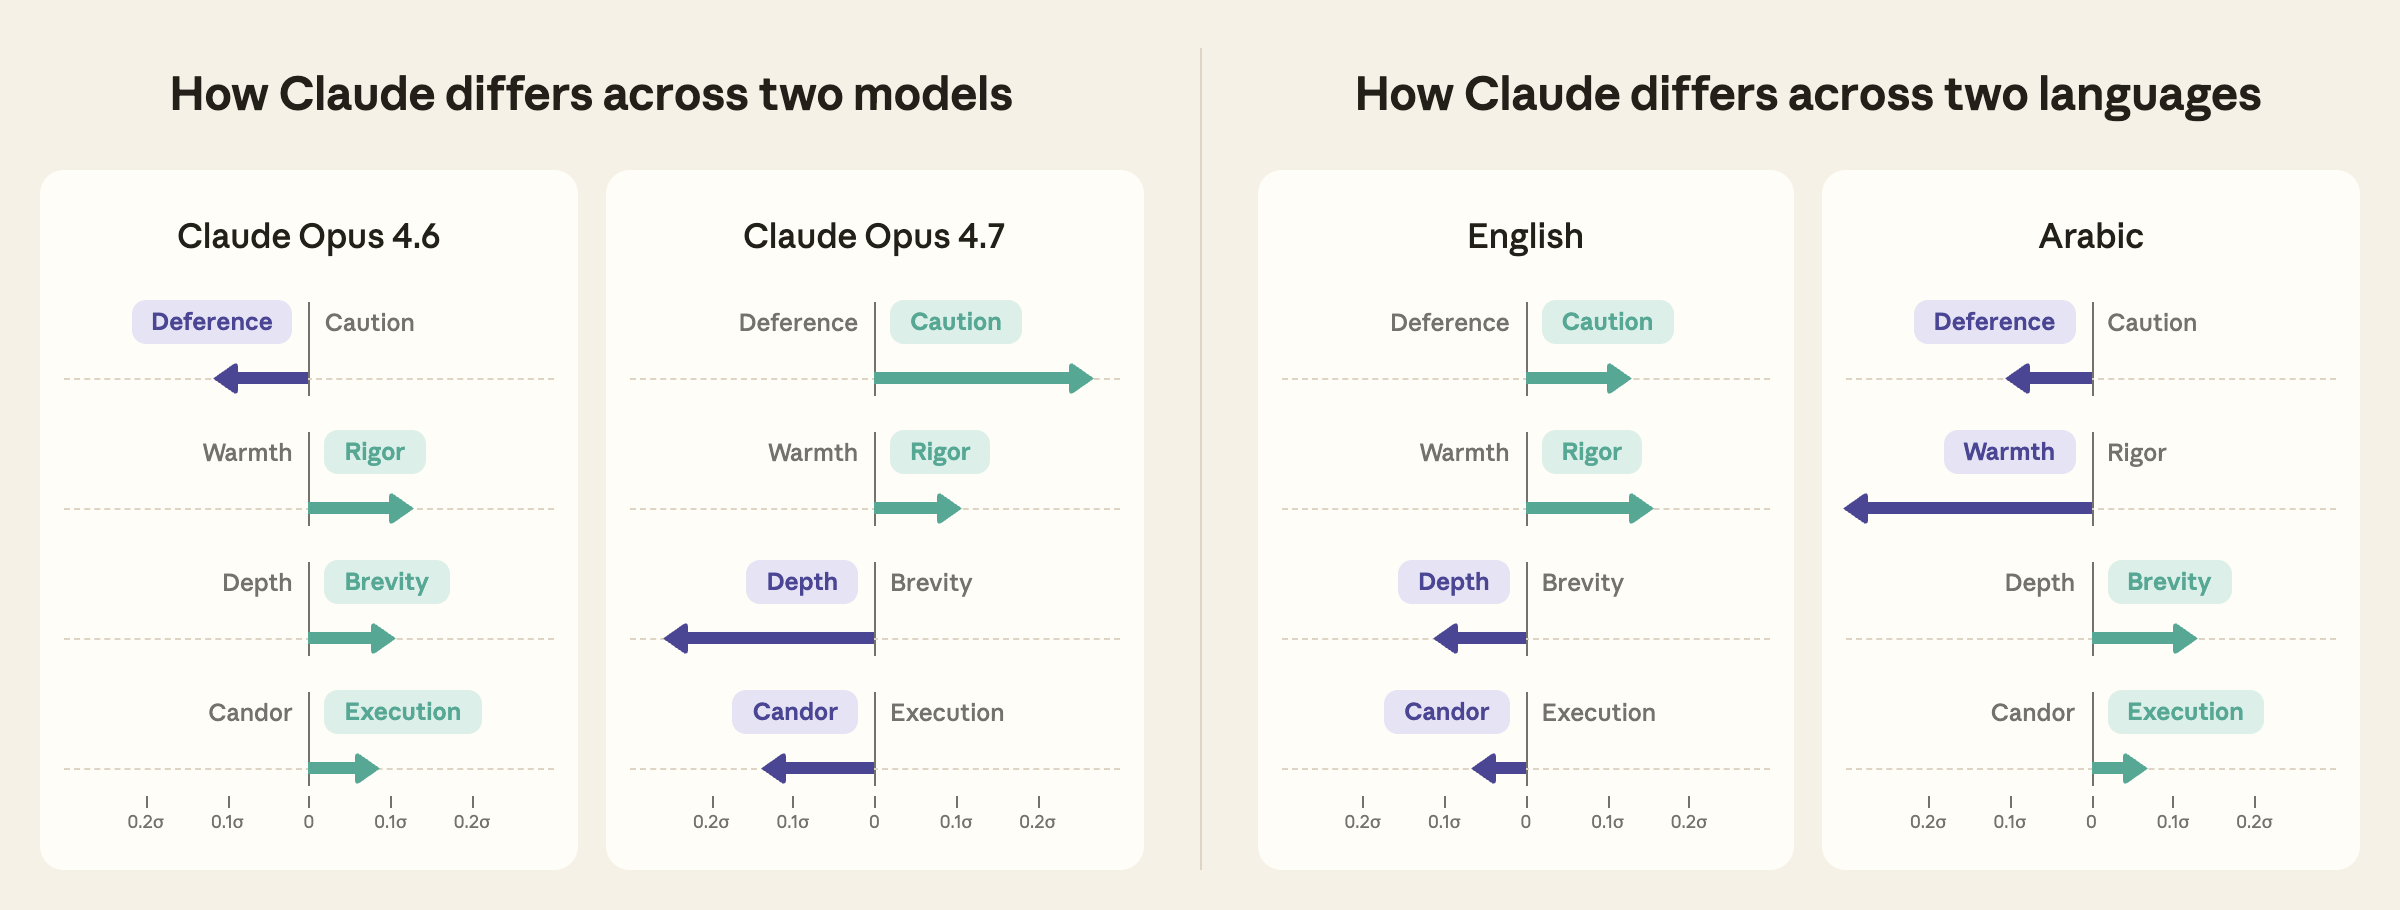
연구진은 대화 과제와 주제, 사용자가 표현한 가치를 통제하고 차원 축소를 적용했다. 네 축이 대화 사이 가치 변동의 15%를 설명했다.
- Deference와 Caution: 사용자 선호 수용과 위험 경계
- Warmth와 Rigor: 긍정·배려와 정확성·정밀함
- Depth와 Brevity: 자세한 설명과 요청 범위의 간결한 수행
- Candor와 Execution: 불확실성 공개와 결과 중심의 답변
양 끝은 배타적인 성질이 아니다. Deference/Caution과 Warmth/Rigor에서는 실제 상충 경향이 관찰됐지만, 나머지 두 축은 행동의 반대말이라기보다 대화를 정리하는 통계적 축에 가깝다.
모델과 언어에 따른 차이
Sonnet 4.6은 Warmth 0.17σ, Deference 0.14σ, Brevity 0.14σ 쪽으로 기울었다. 사용자의 생각을 긍정하고 말투를 맞추거나 유머와 위로를 섞는 행동이 상대적으로 잦았다. Opus 4.6은 Rigor 0.10σ, Deference 0.09σ, Brevity 0.08σ였다. 요청 범위 안에서 요점부터 전달하는 편이었다.
Opus 4.7은 Caution 0.24σ와 Depth 0.23σ가 두드러졌다. 약한 가정을 지적하고, 요청하지 않은 위험도 먼저 알리며, 결론의 이유와 한계를 설명하는 쪽이었다. 이 수치는 성능 점수가 아니다. 전체 대화 평균에서 떨어진 정도를 나타낸다.
언어별로는 힌디어와 아랍어에서 Warmth, 영어와 러시아어에서 Rigor가 높았다. 영어는 Caution과 Depth, 아랍어는 Deference와 Brevity 쪽으로 가장 기울었다. Candor는 네덜란드어, Execution은 인도네시아어에서 높았다.
사용이 필요한 상황
- 다국어 고객 지원에서 언어별 답변 태도를 맞춰야 할 때
- 모델 교체 전후에 비판 강도와 위험 경고가 달라지는지 확인할 때
- 운영 자동화에서 지나친 동조나 과도한 경고를 점검할 때
- 시스템 프롬프트 변경을 행동 회귀 테스트로 관리할 때
시작 방법
Messages API로 비교할 수 있다. API 키를 만든 다음 같은 프롬프트를 여러 모델에 보낸다. 모델 ID는 계정의 목록을 먼저 확인한다.
export ANTHROPIC_API_KEY="YOUR_API_KEY"

curl https://api.anthropic.com/v1/messages \
  -H "content-type: application/json" \
  -H "x-api-key: $ANTHROPIC_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -d '{"model":"claude-sonnet-4-6","max_tokens":500,"messages":[{"role":"user","content":"운영 배포를 하루 앞당기자는 제안을 검토해 주세요. 위험과 실행안을 함께 설명하세요."}]}'
모델 ID와 질문 언어를 바꿔 반복한다. 각 응답이 위험을 먼저 지적하는지, 제안에 얼마나 동조하는지, 근거와 한계를 어느 정도 설명하는지 기록하면 된다.
실습
- 시스템 프롬프트와 토큰 제한을 고정한다.
- 모델과 언어별로 뜻이 같은 질문을 준비한다. 번역문은 원어민이 검토한다.
- 각 조합을 여러 번 호출하고 원문 응답을 저장한다.
- 네 가치 축으로 블라인드 평가한다.
- 모델 또는 프롬프트 변경 전후의 분포를 비교한다.
한두 개 응답만 보고 모델의 성격을 단정하기는 어렵다. 실제 서비스와 가까운 질문 세트를 만들고 반복 측정해야 한다.
알아야 할 사항
네 축이 설명하는 변동은 15%다. 라벨링 도구도 Claude를 사용하며, 언어별 표본은 동일 문장의 번역본이 아니라 실제 대화다.
연구진이 편향과 과제 차이를 통제했지만 인과관계로 볼 수는 없다.
실제 대화를 평가에 쓰려면 개인정보 제거, 접근 권한, 보관 기간을 먼저 정해야 한다.
API 호출 비용과 속도 제한도 계산해야 한다.
작은 프로젝트라면 위험이 큰 대화 흐름 몇 개부터 표본으로 잡는 편이 현실적이다.
장점과 아쉬운 점
장점:
- 모델의 응답 성향을 비교 가능한 축으로 정리한다.
- 실제 Claude.ai 대화로 모델과 언어 차이를 함께 본다.
- 배포 전후 행동 회귀 테스트의 출발점을 제공한다.
아쉬운 점:
- 네 축 밖의 변동이 더 크다.
- 관찰된 차이의 원인과 사용자 영향은 확인되지 않았다.
- 결과를 개별 답변의 품질이나 모델 순위로 해석할 수 없다.
정리
Claude의 답변 태도는 모델과 언어에 따라 측정 가능한 방식으로 달라졌다.
다국어 AI 서비스나 모델 교체를 운영하는 팀이라면 정확도만 볼 수 없다.
동조, 신중함, 설명 깊이, 불확실성 공개도 함께 검사해야 한다.
작은 프롬프트 세트로 먼저 검증하고 필요할 때 범위를 넓힌다. 모델 ID와 API 동작은 바뀔 수 있으므로 적용 전 공식 문서와 릴리스 노트를 다시 확인해야 한다.
참고 자료
'AI > LLM' 카테고리의 다른 글
| [AI]LiteLLM: 하나의 인터페이스로 여러 LLM 사용하기 (0) | 2026.05.26 |
|---|---|
| [AI] Claude Haiku 4.5 출시 (0) | 2025.10.16 |